Estrategia IA · Riesgo y gobierno
La inteligencia artificial no fracasa solo porque un modelo se equivoque. Se convierte en un desastre empresarial cuando ese error llega a una decisión real, escala sin control y nadie tiene autoridad para detenerlo.
Estos diez casos muestran fallos muy distintos: previsiones que destruyeron una línea de negocio, sistemas de selección que reprodujeron sesgos, vehículos autónomos implicados en accidentes, chatbots que dieron información falsa y productos generativos retirados tras resultados ofensivos o inexactos.
La conclusión no es que la IA sea inútil. Es que la precisión media no basta. Una empresa necesita límites de uso, pruebas en condiciones reales, responsables claros, monitorización continua, posibilidad de recurso y un plan de parada. Sin esas defensas, una salida estadísticamente plausible puede convertirse en pérdida, discriminación o daño físico.
Guía inicial: cómo leer estos fracasos de IA
Conviene evitar dos explicaciones cómodas: “el algoritmo tuvo la culpa” y “fue solo un error humano”. La IA opera dentro de un sistema sociotécnico. El riesgo nace de la combinación entre datos, modelo, interfaz, proceso, personas y decisiones de dirección.
Una predicción incorrecta no es todavía un desastre. Lo es cuando activa una compra, un rechazo, una acusación o una maniobra sin barreras suficientes.
Automatizar multiplica velocidad y alcance. Un sesgo pequeño puede afectar a miles de personas antes de que aparezca en un informe mensual.
En cada caso hay una defensa que faltó: validación externa, supervisión humana efectiva, monitorización, trazabilidad o una regla clara de retirada.
10 casos en que la IA fue un desastre para una empresa
Los casos están ordenados para cubrir diferentes tipos de riesgo: financiero, laboral, clínico, físico, legal, reputacional y operativo.
Zillow Offers: cuando predecir el precio de una vivienda no bastó para comprarla
Zillow utilizó modelos y una operación intensiva en datos para comprar, reformar y revender viviendas. El problema no fue únicamente estimar el valor actual, sino anticipar precios futuros y operar inventario físico en un mercado volátil. En noviembre de 2021, la compañía anunció el cierre de Zillow Offers.
Su carta a accionistas reconoció que no podía pronosticar los precios futuros con la precisión necesaria. El cierre implicó una reducción prevista de aproximadamente el 25% de la plantilla y evidenció una diferencia crítica: un error de valoración en una web informa; el mismo error con capital propio compra activos.
Fuente de contraste: carta de Zillow a accionistas del tercer trimestre de 2021 y comunicación a inversores.
Amazon: un sistema de selección que aprendió a penalizar señales asociadas a mujeres
Amazon desarrolló una herramienta experimental para puntuar currículos a partir de candidaturas históricas. Como el conjunto de entrenamiento reflejaba años de predominio masculino en puestos técnicos, el sistema aprendió patrones que perjudicaban términos asociados a mujeres.
La empresa trató de corregir variables explícitas, pero no pudo garantizar que el modelo no reconstruyera el sesgo mediante otros indicadores y abandonó el proyecto. El caso se convirtió en un referente porque muestra que eliminar un atributo protegido no elimina necesariamente su huella estadística.
Fuente de contraste: investigación de Reuters publicada en octubre de 2018 y declaraciones de la compañía recogidas en ella.
IBM Watson for Oncology: prometer apoyo médico antes de demostrar utilidad clínica
Watson for Oncology aspiraba a convertir literatura médica y conocimiento experto en recomendaciones de tratamiento. Sin embargo, investigaciones periodísticas documentaron que profesionales de distintos países consideraban algunas recomendaciones poco fiables, sesgadas hacia prácticas estadounidenses o potencialmente inseguras.
El proyecto también expuso la dificultad de extraer contexto clínico de historias médicas reales. MD Anderson había detenido una iniciativa vinculada a Watson tras una inversión relevante. La brecha entre una demostración convincente y un sistema clínico validado resultó demasiado grande.
Fuentes de contraste: investigación de STAT resumida por la Association of Health Care Journalists; auditoría pública de MD Anderson; documentación corporativa de IBM.
Uber ATG: el accidente mortal que reveló una cultura de seguridad insuficiente
En marzo de 2018, un vehículo de pruebas de Uber Advanced Technologies Group atropelló mortalmente a una peatona en Tempe, Arizona. La investigación de la National Transportation Safety Board atribuyó la causa probable a la falta de atención de la operadora de seguridad y señaló varios factores organizativos contribuyentes.
Entre ellos figuraban procedimientos inadecuados de evaluación de riesgos, supervisión ineficaz de operadores y falta de mecanismos para gestionar la complacencia ante la automatización. Es decir, el sistema humano había sido diseñado como respaldo, pero el diseño operativo no garantizaba que ese respaldo funcionara.
Fuente de contraste: investigación HWY18MH010 de la National Transportation Safety Board.
Cruise: un robotaxi arrastró a una peatona y la respuesta agravó la crisis
En octubre de 2023, una peatona golpeada inicialmente por otro vehículo cayó en la trayectoria de un robotaxi de Cruise. El vehículo autónomo realizó después una maniobra que la arrastró. El Departamento de Vehículos Motorizados de California suspendió los permisos de despliegue y pruebas sin conductor.
El regulador citó riesgo irrazonable para la seguridad y tergiversación de información relacionada con el incidente. Cruise detuvo sus operaciones sin conductor en Estados Unidos y encargó revisiones externas. Aquí, el problema técnico y la gestión de la transparencia se combinaron en una misma crisis.
Fuentes de contraste: California DMV, informe independiente encargado por Cruise y documentación pública de General Motors.
Rite Aid: miles de falsos positivos en reconocimiento facial
Rite Aid utilizó reconocimiento facial en cientos de tiendas para identificar a supuestas personas de interés. Según la Federal Trade Commission, el sistema generó miles de falsos positivos y clientes fueron seguidos, registrados, expulsados o acusados públicamente a partir de alertas erróneas.
La FTC sostuvo que la compañía no probó adecuadamente la precisión, empleó imágenes de baja calidad, no monitorizó de forma continua y no formó suficientemente al personal. El acuerdo prohibió a Rite Aid usar reconocimiento facial para vigilancia durante cinco años y exigió salvaguardas adicionales.
Fuente de contraste: queja y orden de la Federal Trade Commission contra Rite Aid, 2023-2024.
Air Canada: el chatbot dio una política falsa y la empresa respondió por ella
Un cliente consultó al chatbot de Air Canada sobre tarifas por fallecimiento. La respuesta indicaba que podía solicitar retroactivamente un descuento, aunque la política publicada exigía otro procedimiento. El Civil Resolution Tribunal de Columbia Británica concluyó que la información había sido negligentemente tergiversada.
El aspecto más recordado del caso fue el argumento de que el chatbot funcionaba como una entidad separada. El tribunal lo rechazó: la empresa es responsable de la información que publica en su web, con independencia de si procede de una página estática o de un asistente automático.
Fuente de contraste: Moffatt v. Air Canada, 2024 BCCRT 149.
Microsoft Tay: un chatbot público manipulado en menos de un día
Microsoft lanzó Tay en Twitter en marzo de 2016 como experimento conversacional dirigido a jóvenes. Usuarios coordinaron ataques para explotar una vulnerabilidad y provocar respuestas ofensivas. La empresa retiró el bot y pidió disculpas.
Microsoft explicó que había aplicado filtros y pruebas, pero no anticipó ese vector específico de abuso. Tay demostró que el comportamiento de un sistema conectado al público depende también de adversarios, incentivos de la plataforma y velocidad de propagación.
Fuente de contraste: comunicado oficial de Microsoft “Learning from Tay’s introduction”, marzo de 2016.
Google Gemini: imágenes históricas inexactas y una función pausada
En febrero de 2024, Google pausó la generación de imágenes de personas en Gemini después de que el producto generara resultados históricamente inexactos, ofensivos en algunos contextos o excesivamente restrictivos ante peticiones normales.
La propia compañía explicó que sus ajustes para promover diversidad y evitar contenidos problemáticos no habían tenido en cuenta situaciones donde la representación debía responder con precisión a un contexto histórico concreto. El sistema sobrecompensó: una salvaguarda válida en un escenario produjo errores en otro.
Fuente de contraste: explicación oficial de Google “Gemini image generation got it wrong”, febrero de 2024.
McDonald’s e IBM: tres años de pedidos automáticos que no llegaron a escalar
McDonald’s probó desde 2021 un sistema de toma automática de pedidos por voz de IBM en más de cien restaurantes. En 2024 decidió finalizar la prueba y retirar la tecnología de los establecimientos participantes. Durante el piloto, clientes difundieron errores llamativos y medios especializados recogieron problemas con acentos, dialectos y ruido.
La compañía no renunció a la automatización por voz; de hecho, afirmó que seguía viéndola como parte del futuro. La lección es más precisa: una tecnología prometedora puede no estar lista para ese proveedor, ese flujo o ese nivel de variabilidad operacional.
Fuentes de contraste: declaraciones de McDonald’s e IBM recogidas por Associated Press y medios sectoriales en junio de 2024.
Qué patrones comparten estos desastres empresariales con IA
| Caso | Tipo de IA | Daño principal | Control que faltó |
|---|---|---|---|
| Zillow | Predicción y valoración | Financiero | Límites de exposición ante incertidumbre |
| Amazon | Ranking de candidatos | Discriminación | Auditoría de sesgo y validez de etiquetas |
| IBM Watson | Apoyo a decisión clínica | Clínico y reputacional | Validación prospectiva contextual |
| Uber ATG | Conducción autónoma | Seguridad física | Supervisión humana efectiva |
| Cruise | Conducción autónoma | Seguridad y regulación | Respuesta extrema y transparencia |
| Rite Aid | Reconocimiento facial | Derechos y reputación | Verificación y monitorización de falsos positivos |
| Air Canada | Chatbot | Legal y cliente | Fuente única de políticas y escalado |
| Microsoft Tay | IA conversacional | Reputacional | Pruebas adversariales y moderación |
| Google Gemini | Generación de imágenes | Calidad y reputación | Evaluación por contexto |
| McDonald’s | Reconocimiento de voz | Operativo y cliente | Pruebas de larga cola en entorno real |
La pregunta correcta no es “¿qué precisión tiene el modelo?”, sino “¿qué ocurre cuando se equivoca, quién lo detecta y cuánto daño puede acumular antes de que alguien lo detenga?”.
Las 7 causas raíz que convierten un error de IA en un desastre
El modelo optimiza una aproximación cómoda, como decisiones históricas, aunque no represente el resultado que la empresa realmente quiere.
El histórico contiene sesgos, cambios de mercado, casos incompletos o condiciones distintas a las del despliegue.
Una buena precisión global puede ocultar daños concentrados en minorías, escenarios raros o momentos de alta criticidad.
La salida pasa directamente a la acción y elimina justo la pausa en la que un experto podría detectar una anomalía.
Hay una persona “en el circuito”, pero sin tiempo, información, formación o autoridad para corregir al sistema.
El piloto demuestra viabilidad técnica, pero no robustez operacional, adopción, rentabilidad ni seguridad a gran escala.
La empresa no registra incidentes, minimiza señales tempranas o comunica solo una parte del problema.
Cómo evitar que un proyecto de IA termine igual
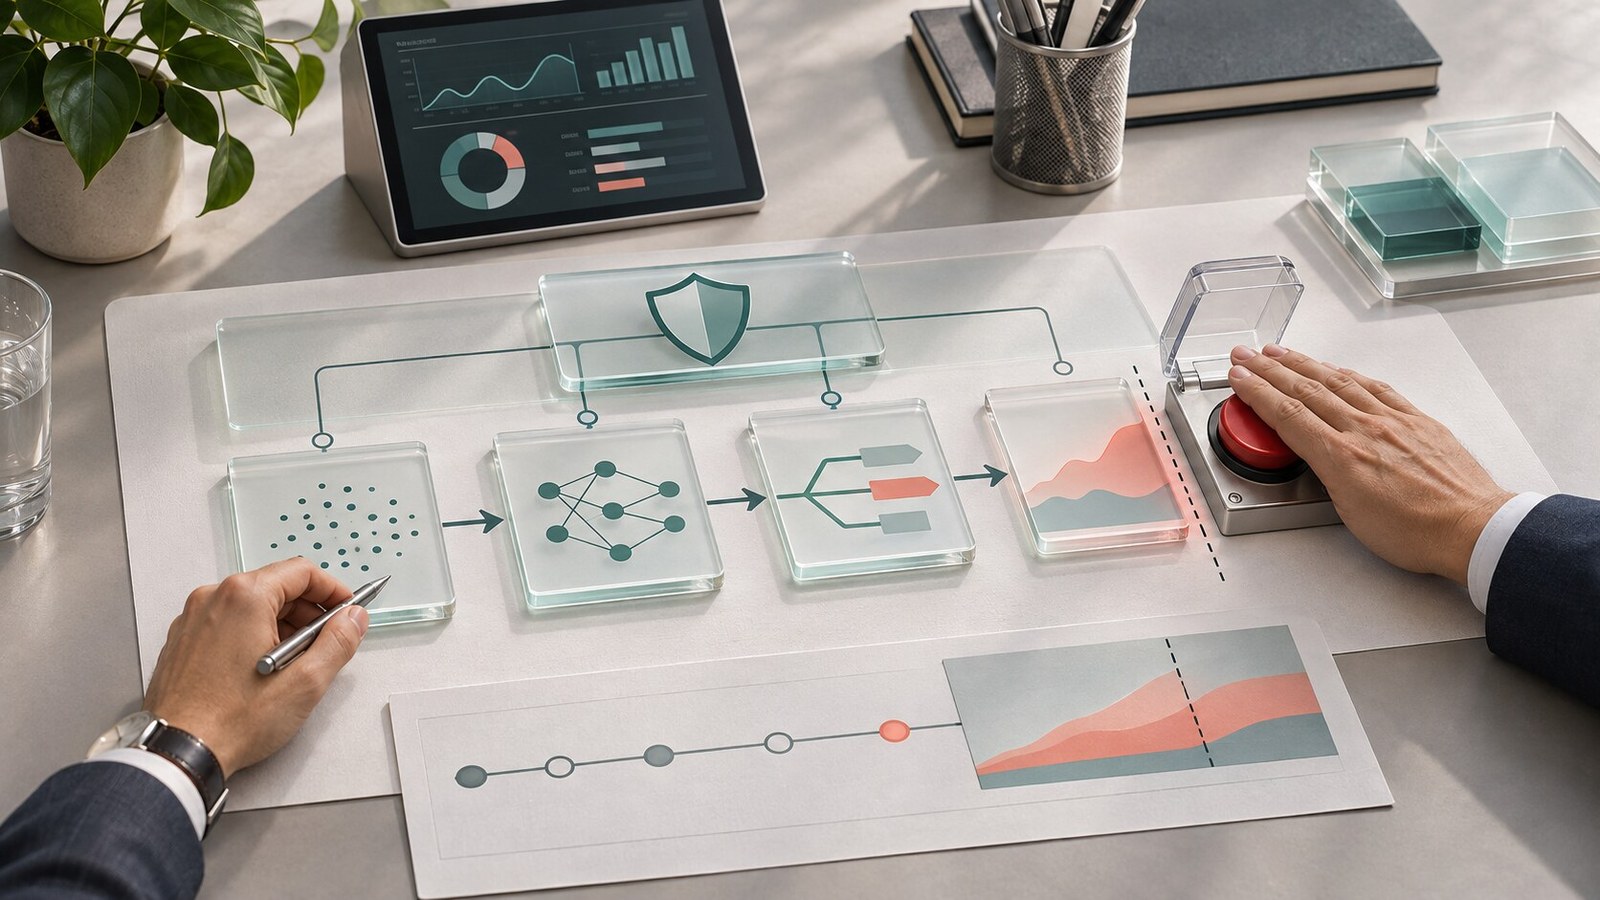
El punto de partida no debería ser elegir un modelo, sino definir una decisión y su coste de error. Datision propone seleccionar el primer proyecto de IA por impacto, datos, posibilidad de intervención y compromiso del equipo. Esa disciplina reduce la tentación de escalar una demostración antes de convertirla en sistema.
Checklist de salida a producción
- Decisión, usuario y propósito documentados.
- Coste de falsos positivos y falsos negativos cuantificado.
- Pruebas por segmento, escenario extremo y cambio de contexto.
- Responsable de negocio con autoridad de parada.
- Supervisión humana con tiempo e información suficientes.
- Registro de versiones, datos, salidas e intervenciones.
- Canal de reclamación y revisión para personas afectadas.
- Umbrales de degradación y plan de reversión.
- Monitorización de impacto técnico y de negocio.
- Comunicación de incidentes clara, completa y rápida.
Para ordenar la cartera, conviene usar un marco que combine retorno, viabilidad del dato y cambio organizativo. Esta guía sobre ROI de IA industrial y priorización de casos ayuda a separar un proyecto atractivo de uno defendible. Como referencia externa, el AI Risk Management Framework de NIST organiza el trabajo en cuatro funciones continuas: gobernar, mapear, medir y gestionar.
Preguntas frecuentes
¿Cuál ha sido el mayor fracaso empresarial causado por IA?
No existe una única respuesta porque el daño se mide de formas distintas. Zillow destaca por el impacto financiero y organizativo; Uber ATG y Cruise, por seguridad física; Rite Aid, por daño a personas y acción regulatoria; e IBM Watson for Oncology, por el riesgo de aplicar recomendaciones poco fiables en salud.
¿Estos casos demuestran que la inteligencia artificial no funciona?
No. Demuestran que un modelo útil puede fallar cuando se aplica fuera de su contexto, recibe demasiada autonomía o se escala sin controles. Varias de estas empresas siguieron desarrollando o utilizando IA después del incidente, pero modificaron productos, proveedores o procesos.
¿Qué error se repite con más frecuencia?
Confundir rendimiento técnico con preparación operacional. Una métrica alta en pruebas no demuestra que el sistema se comporte bien con datos nuevos, grupos minoritarios, usuarios hostiles, ruido, excepciones o consecuencias reales.
¿Quién debe ser responsable de una decisión tomada con IA?
La responsabilidad debe permanecer en la organización que diseña, compra o utiliza el sistema. Hace falta un dueño de negocio identificable, responsabilidades técnicas y legales claras, y personas con autoridad real para revisar, corregir o detener el proceso.
¿Cómo se prueba una IA antes de desplegarla?
Además de medir precisión, hay que probar subgrupos, casos límite, datos degradados, ataques, cambios de contexto y consecuencias de cada tipo de error. En sistemas críticos se necesita validación independiente, despliegue gradual, monitorización continua y un modo seguro de fallo.
¿Qué debe hacer una empresa cuando detecta un incidente de IA?
Contener el daño, preservar evidencias, detener o limitar el sistema, informar a responsables y afectados, analizar la causa raíz y definir criterios verificables antes de reactivarlo. La comunicación debe explicar tanto el fallo técnico como las decisiones organizativas que lo permitieron.
La mejor defensa empieza antes del piloto
Un buen caso de IA combina impacto, señal en los datos, capacidad de actuar y controles proporcionales al riesgo. El trabajo útil consiste en demostrar esas cuatro condiciones antes de comprometer escala, reputación o seguridad.
Priorizar casos de IA con evidencia