Continuidad operativa · IA industrial · Mantenimiento
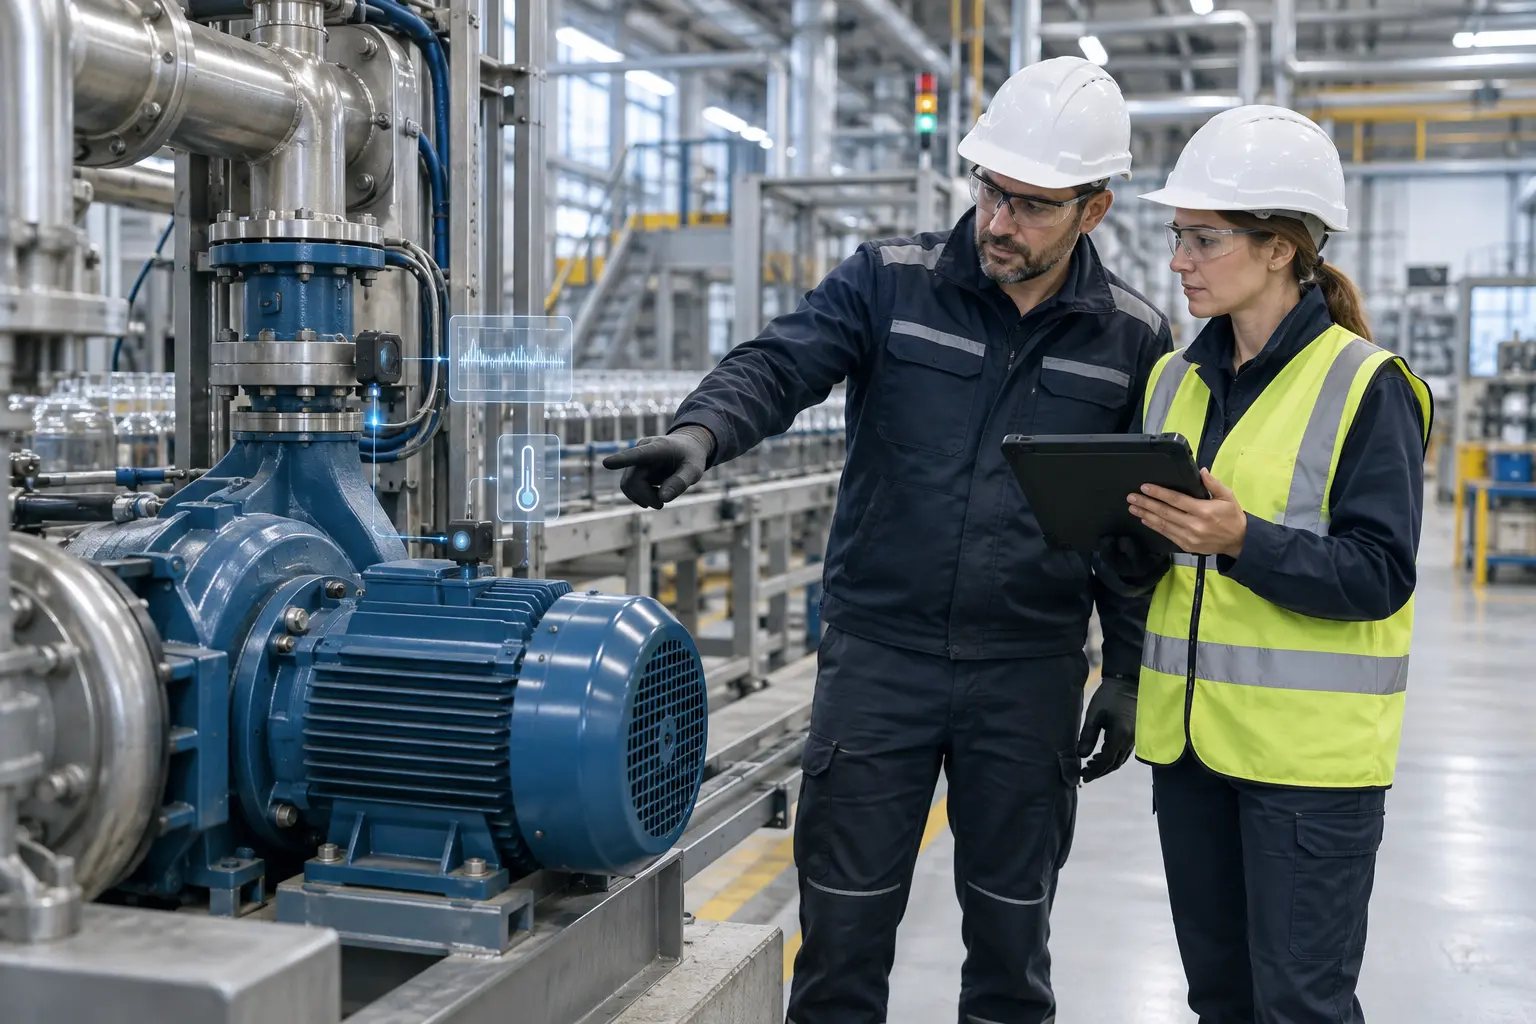
Una parada no planificada rara vez cuesta solo la reparación. También consume producción, calidad, energía, horas de equipo, logística y confianza del cliente. El mantenimiento predictivo con IA ayuda a detectar la degradación con antelación y a convertirla en una intervención programada, siempre que la alerta esté conectada con una decisión real.
Resumen inicial
El mantenimiento predictivo con IA puede prevenir paradas no planificadas al identificar patrones de degradación antes del fallo, estimar el nivel de riesgo y priorizar la intervención. El ahorro aparece cuando la planta transforma esa antelación en una parada corta y programada, evita daños secundarios y coordina repuestos, personal y producción.
- Empieza por un activo crítico y uno o dos modos de fallo.
- Mide horas y margen evitado, no solo precisión del modelo.
- Integra la alerta con el flujo de mantenimiento y su cierre.
Guía inicial para el lector
- Si buscas entender el mecanismo: empieza por cómo una señal se convierte en una parada evitada.
- Si necesitas justificar la inversión: revisa el modelo de coste evitable y los KPIs económicos.
- Si vas a lanzar un piloto: utiliza la matriz de priorización y la hoja de ruta de 90 días.
- Si ya tienes alertas: céntrate en su integración con CMMS/EAM y en la fatiga por falsos positivos.
Sí, el mantenimiento predictivo con IA puede prevenir paradas no planificadas y ahorrar dinero, pero no porque “adivine” todas las averías. Lo consigue detectando cambios anómalos con tiempo suficiente, estimando su relevancia y activando una respuesta planificada. La predicción es solo el inicio; el resultado depende de que mantenimiento y producción puedan actuar antes de que el riesgo se materialice.
Por qué una parada no planificada cuesta más que una reparación
Cuando un activo crítico se detiene, la factura no termina en el rodamiento, el motor o la mano de obra. El impacto se propaga por la línea: se pierde capacidad, aparece producto fuera de especificación, se alteran secuencias, se aceleran envíos y se desplaza trabajo preventivo para atender la urgencia.
Coste directo
Repuestos, horas técnicas, asistencia externa y tiempo medio de reparación.
Coste operativo
Producción perdida, merma, reinicio, energía improductiva y cuello de botella.
Coste de servicio
Retrasos, expediciones urgentes, penalizaciones y deterioro del cumplimiento.
El objetivo económico no es eliminar cualquier fallo a cualquier precio. Es reducir la exposición a los fallos cuyo coste esperado supera claramente el coste de monitorizar, analizar e intervenir. Por eso el primer paso no es comprar sensores: es identificar dónde una hora de indisponibilidad tiene una consecuencia de negocio relevante.
Cómo convierte la IA una señal débil en una parada evitada
Los umbrales clásicos funcionan bien cuando una variable aislada define el riesgo. Sin embargo, muchos activos se degradan mediante combinaciones más sutiles: una vibración que cambia solo a cierta carga, un consumo que se desplaza según la receta o una temperatura que tarda más en estabilizarse. La IA puede aprender esas relaciones multivariables y comparar el comportamiento actual con el esperado.
Este ciclo explica la diferencia entre monitorizar y prevenir. Una alerta aislada puede ser interesante; una alerta contextualizada, asignada y cerrada puede desplazar la intervención desde la urgencia hacia una ventana controlada. La guía de Datision sobre mantenimiento predictivo con IA amplía la relación entre datos, decisiones y adopción operativa.
Qué datos ayudan a anticipar fallos
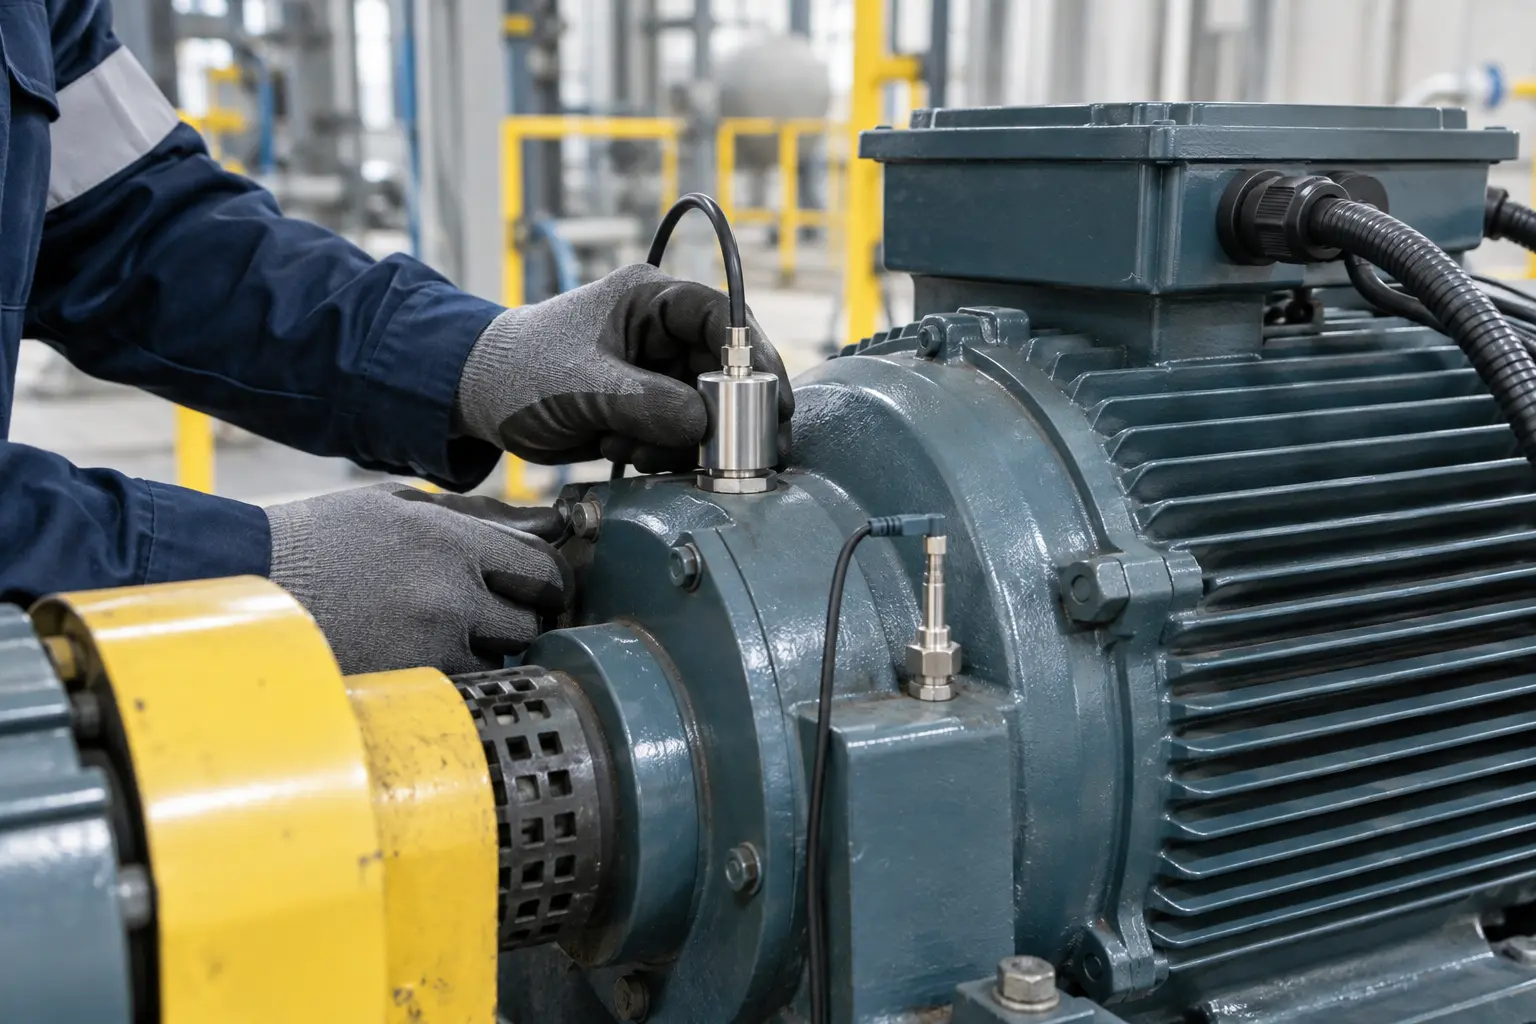
No existe una lista universal de sensores. La selección depende del mecanismo físico de degradación, del régimen de funcionamiento y del margen necesario para intervenir. En muchos proyectos, la calidad de la sincronización y del contexto aporta más que aumentar la frecuencia de captura sin criterio.
| Fuente | Qué puede revelar | Contexto necesario | Ejemplos de activo |
|---|---|---|---|
| Vibración | Desequilibrio, desalineación, holgura o degradación de rodamientos. | Velocidad, carga, punto de medida y montaje del sensor. | Motores, bombas, ventiladores, reductores. |
| Temperatura | Fricción, lubricación deficiente, sobrecarga o refrigeración anómala. | Temperatura ambiente, régimen y tiempo de estabilización. | Rodamientos, hornos, cuadros, hidráulica. |
| Corriente y potencia | Cambios de esfuerzo, atasco, pérdida de eficiencia o anomalía eléctrica. | Consigna, producto, carga y ciclo de trabajo. | Motores, compresores, transportadores. |
| Presión, caudal y acústica | Fugas, cavitación, obstrucciones o comportamiento irregular. | Modo operativo, válvulas, materia prima y ambiente. | Bombas, circuitos neumáticos e hidráulicos. |
| PLC, SCADA y CMMS/EAM | Secuencias, microparadas, alarmas, causas e intervenciones. | Timestamp común, taxonomía estable y jerarquía de activos. | Líneas automatizadas y celdas de producción. |
Cuando hay pocos fallos etiquetados, no siempre conviene esperar años para reunirlos. Los modelos de comportamiento normal y la detección de anomalías pueden identificar desviaciones sin necesitar una gran colección de averías. Después, el conocimiento del técnico sirve para validar si la desviación representa degradación, un cambio de receta o una condición normal todavía no modelada.
Cómo calcular el ahorro sin prometer cifras irreales
El ahorro debe compararse con una línea base y expresarse como un rango. La planta necesita conocer la frecuencia histórica del evento, su duración, la capacidad afectada y la proporción de alertas que realmente permiten actuar. Una forma práctica de estructurar el análisis es separar el coste potencial de la parada y la fracción razonablemente evitable.
Modelo básico de coste evitable
Ejemplo ilustrativo: si una línea sufre cuatro eventos anuales de cinco horas y un piloto permite anticipar dos de ellos, trasladando cada intervención a una ventana que evita tres horas de paro, la oportunidad equivale a seis horas recuperadas. El valor final depende del margen o coste real por hora, de la reparación planificada y del coste total de operar la solución.
Este ejemplo explica el método; no constituye una estimación aplicable a otra planta. Deben añadirse incertidumbre, estacionalidad y escenarios conservador, probable y exigente.
La revisión sistemática publicada por el National Institute of Standards and Technology (NIST) subraya precisamente la necesidad de evaluar estas tecnologías con medidas de rendimiento e impacto económico, y señala que los estudios existentes utilizan metodologías heterogéneas. En la práctica, esto aconseja documentar supuestos y hacer análisis de sensibilidad en vez de trasladar porcentajes genéricos a cualquier instalación.
Elegir el activo correcto: una matriz de cinco criterios
El mejor piloto no tiene por qué ser la máquina más cara. Es el caso en el que coinciden impacto, señal observable y capacidad de respuesta. Puntuar cada candidato de 1 a 5 permite comparar alternativas con mantenimiento, producción, calidad y finanzas alrededor de una misma mesa.
| Criterio | Pregunta de decisión | Señal favorable |
|---|---|---|
| Criticidad | ¿Qué ocurre si este activo se detiene? | Afecta a seguridad, cuello de botella, calidad o entrega. |
| Detectabilidad | ¿Existe un precursor medible antes del fallo? | La señal cambia con margen suficiente para inspeccionar. |
| Datos | ¿Podemos relacionar señal, contexto e intervención? | Identificador y timestamps consistentes entre sistemas. |
| Accionabilidad | ¿Qué hará el equipo si aparece la alerta? | Hay inspección, responsable, repuesto y ventana posibles. |
| Repetibilidad | ¿El aprendizaje puede escalar? | Existe una familia de activos o modos de fallo similares. |
Para aterrizar esta evaluación en un entorno real, la solución de Datision de mantenimiento predictivo industrial con IA plantea la predicción de fallo y la vida útil remanente como instrumentos de continuidad y coste medible.
Hoja de ruta de 90 días para un piloto operativo
Problema y línea base
Elegir activo y fallo, cuantificar paradas, mapear datos y definir la decisión que debe mejorar.
Datos y validación
Sincronizar señales, crear contexto, explorar patrones y validar hipótesis con técnicos.
Piloto en sombra
Emitir alertas sin automatizar órdenes, medir ruido, ajustar umbrales y acordar el escalado.
El modo sombra es especialmente útil: permite comparar las predicciones con inspecciones y eventos reales antes de que una alerta genere una orden automática. Así se descubren condiciones normales no contempladas, cambios entre turnos o recetas y problemas de calidad de dato sin trasladar ruido al equipo.
Una buena alerta debe responder en segundos: qué activo está en riesgo, qué ha cambiado, con qué severidad, qué margen existe y cuál es la comprobación recomendada.
Tras la validación, la integración con el CMMS/EAM debe conservar la trazabilidad: alerta, revisión, decisión, orden de trabajo, hallazgo, causa y resultado. Ese cierre alimenta el aprendizaje y permite demostrar si la intervención fue útil o solo coincidió con una anomalía sin impacto.
KPIs que conectan la IA con disponibilidad y ahorro
| Dimensión | KPI | Qué responde |
|---|---|---|
| Anticipación | Antelación útil | ¿Hubo tiempo real para inspeccionar, preparar y decidir? |
| Calidad de alerta | Alertas accionables y falsos positivos | ¿El sistema prioriza o añade fatiga? |
| Fiabilidad | Paradas no planificadas, MTBF y disponibilidad | ¿Mejora la continuidad ajustada por horas de operación? |
| Ejecución | Tiempo alerta-decisión y porcentaje de cierres documentados | ¿La organización actúa y aprende? |
| Economía | Horas recuperadas, coste correctivo y coste evitado validado | ¿El beneficio supera el coste total de la capacidad? |
No conviene atribuir todo cambio de OEE o disponibilidad al modelo. Ajusta la comparación por volumen, mix de producto, estacionalidad y modificaciones de proceso. La pieza de Datision sobre mantenimiento predictivo con IA en plantas industriales desarrolla con más detalle la selección de señales, las alertas y los indicadores de adopción.
Qué impide que el mantenimiento predictivo ahorre dinero
- Sensorizar sin hipótesis: se acumulan datos sin saber qué decisión deben mejorar.
- Ignorar el régimen: el modelo confunde cambios de carga o receta con degradación.
- Optimizar solo precisión: una métrica técnica alta no garantiza antelación ni acción.
- No fijar responsables: la alerta llega, pero nadie debe revisarla ni cerrarla.
- Automatizar demasiado pronto: las órdenes prematuras erosionan la confianza del equipo.
- Medir sin línea base: no puede demostrarse qué coste se evitó ni qué cambió.
También es importante aceptar que no todos los fallos son predecibles. Algunos son abruptos, otros no tienen una señal accesible y otros cuestan menos que el sistema necesario para anticiparlos. Un programa maduro combina mantenimiento correctivo, preventivo, basado en condición y predictivo según el riesgo de cada activo.
Preguntas frecuentes
¿La IA puede evitar todas las paradas no planificadas?
No. Puede reducir las asociadas a degradaciones observables y con margen de actuación. Fallos súbitos, causas externas o modos sin señal previa requieren otras barreras de fiabilidad y contingencia.
¿Hace falta instalar muchos sensores?
No necesariamente. Muchas plantas pueden empezar con señales existentes en PLC, SCADA, variadores o sistemas de calidad. Se añaden sensores cuando cubren una hipótesis concreta y mejoran la anticipación o el diagnóstico.
¿Qué diferencia hay entre mantenimiento preventivo y predictivo?
El preventivo interviene por calendario, horas o ciclos. El predictivo utiliza la condición real y su evolución para estimar el riesgo y ajustar el momento de la intervención.
¿Se puede empezar si hay pocos fallos históricos?
Sí. La detección de anomalías y los modelos de comportamiento normal pueden trabajar con datos de operación saludable. La validación del técnico y el registro disciplinado de nuevos eventos resultan esenciales.
¿Cuándo empieza a generar ahorro?
Cuando una alerta validada cambia una decisión: permite preparar repuestos, agrupar tareas, intervenir en una ventana o evitar daño secundario. Por eso el piloto debe medir el ciclo completo, no solo la salida del algoritmo.
¿La IA sustituye al personal de mantenimiento?
No. Automatiza vigilancia y priorización, mientras el equipo aporta contexto físico, valida causas y decide cómo intervenir. El sistema mejora cuando ese conocimiento queda documentado.
Conclusión: anticipar solo sirve si permite actuar
El mantenimiento predictivo con IA puede reducir paradas no planificadas, proteger la producción y contener costes, pero su valor no reside en generar más alarmas. Reside en ampliar la ventana de decisión y dirigir recursos hacia el riesgo que realmente importa.
Un primer proyecto defendible tiene un activo crítico, un modo de fallo concreto, señales contextualizadas, una respuesta acordada y una línea base económica. Con ese marco, cada alerta puede conectarse con una inspección, cada intervención con un resultado y cada ampliación con evidencia.